心理效应档案
76 个心理效应
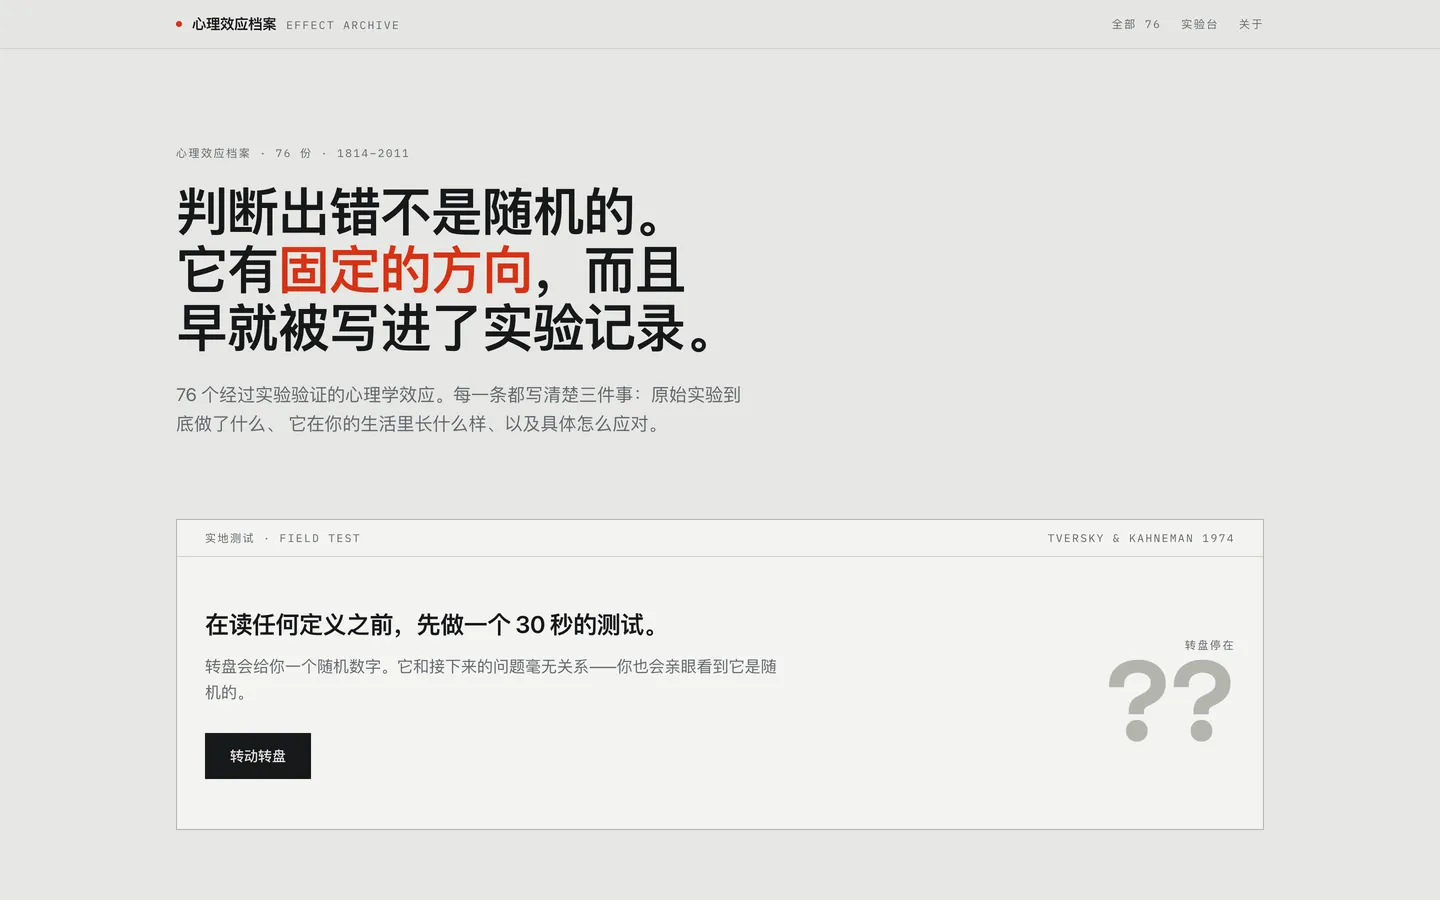
判断出错不是随机的。它有固定的方向,而且早就被写进了实验记录。
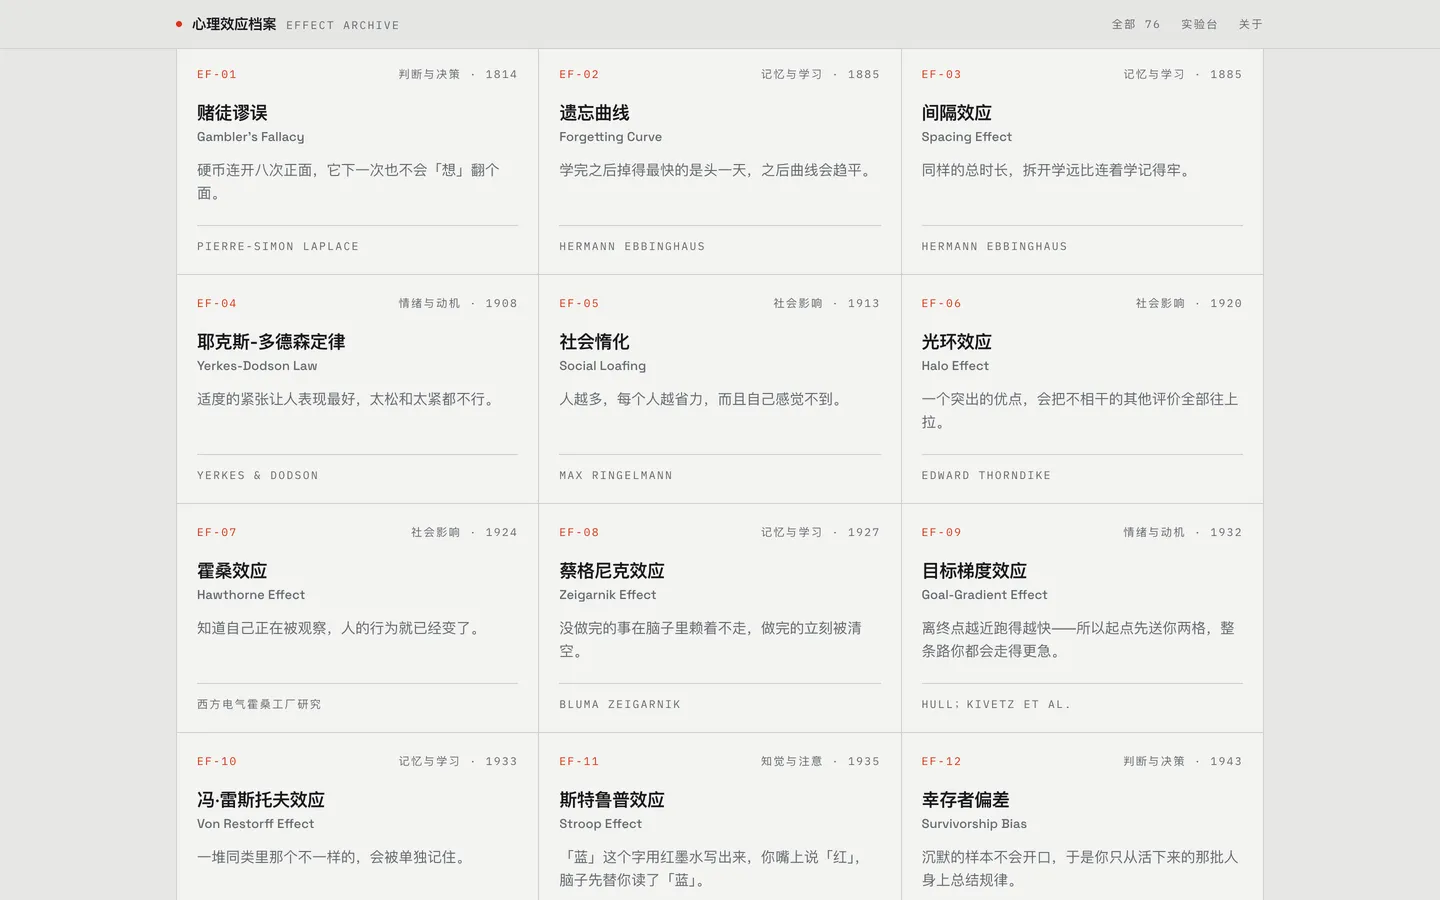
这是一份 76 条的档案,跨度从 1814 年到 2011 年。每一条写清楚三件事:原始实验到底做了什么、它在你的生活里长什么样、以及具体怎么应对。
先做测试,再读定义
首屏不解释任何东西,先让你转一个转盘。
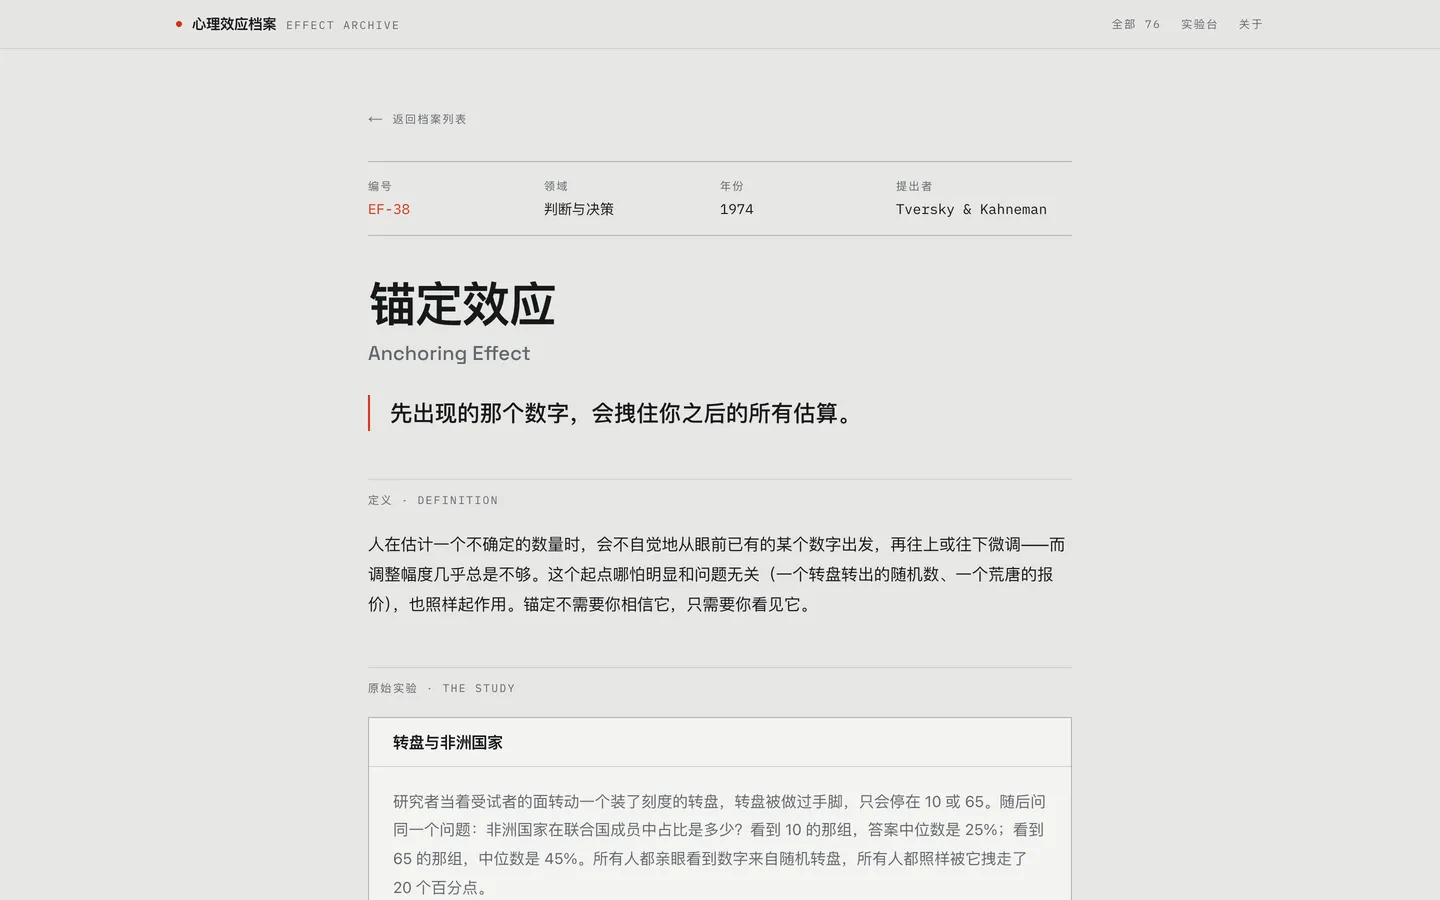
转盘会给你一个随机数字,然后问你一个跟它毫无关系的问题——非洲国家在联合国成员中占比是多少。这是 Tversky 和 Kahneman 1974 年那个实验的复现:他们当着受试者的面转一个做了手脚的转盘(只会停在 10 或 65),看到 10 的那组答案中位数是 25%,看到 65 的那组是 45%。所有人都亲眼看到数字来自随机转盘,所有人都照样被它拽走了 20 个百分点。
锚定不需要你相信它,只需要你看见它。 这句话读一遍不如自己栽一次,所以它排在所有定义前面。
每条档案的结构
编号、领域、年份、提出者放在最上面一行——这份东西的定位是档案,不是科普文章,所以元信息优先。
正文固定五段:定义、原始实验、生活中的表现、应对方法、相关效应。「原始实验」那一段是重点:多数科普只给结论,而结论脱离了实验条件往往就不成立。这里把实验怎么做的、样本什么样、结果差多少都写出来,你自己判断它能推广到哪。
一条自己给自己立的规矩
条目数在页面上一律由 totalCount 推导,不要写死数字。
这条写进了项目 README。原因很实际:一个「76 个效应」的站,标题、导航、meta description、about 页会各写一遍这个数字,加第 77 条时必然漏掉一两处。让它们全部从同一个数组的长度算出来,就不存在漏改。
技术
Next.js 16 App Router + Tailwind v4 + TypeScript,全站静态生成,无数据库、无 API。
内容源按分类分文件放在 src/data/effects/ 下,汇总层负责排序(按年份)、编号和搜索。实验台的元数据里有一个必填的 caveat 字段——任何一个可交互的复现实验都必须写清楚它跟原始实验的差别在哪,不允许留空。
- 上线
- 2026
- 我的角色
- 独立开发
- 技术栈
- Next.jsTypeScriptTailwind